
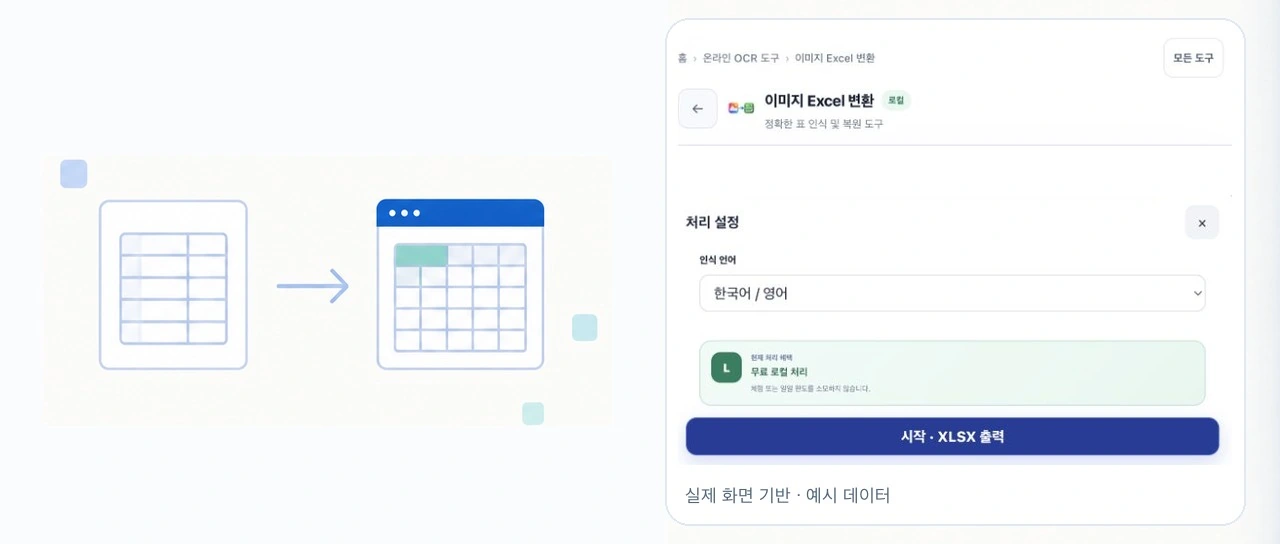
스크린샷이나 스캔 PDF에 있는 표는 이미지로 준비한 뒤 표 OCR로 인식하면 엑셀에서 편집할 수 있는 XLSX 파일로 옮길 수 있습니다. 이미 이미지인 표는 바로 인식하고, 스캔 PDF는 페이지별 이미지로 내보내는 단계부터 시작하세요.
OOCCRR의 PDF를 이미지로와 이미지 Excel 변환은 브라우저에서 로컬로 처리합니다. 이 두 도구에서는 변환할 문서나 이미지를 서버에 업로드하지 않습니다. 다만 OCR은 원본을 그대로 복원하는 작업이 아니므로, 다운로드 전에 글자와 숫자, 행·열을 확인해야 합니다.
내 파일은 어디서 시작하면 될까요?
OCR은 이미지에 보이는 글자를 읽는 기술입니다. 표 OCR은 여기에 행과 열의 구조를 함께 추정해 셀로 나눕니다. 읽기 쉬운 이미지라도 제목, 빈칸, 병합 셀 때문에 구조가 달라질 수 있습니다.
| 가지고 있는 파일 | 시작할 작업 | 확인할 점 |
|---|---|---|
| 화면 캡처·PNG·JPG 표 | 이미지 Excel 변환에 이미지 추가 | 표 전체와 글자가 선명하게 보이는지 |
| 스캔 PDF·사진이 들어 있는 PDF | PDF를 페이지별 이미지로 내보낸 뒤 인식 | 필요한 페이지와 출력 해상도 |
| 글자를 선택하고 복사할 수 있는 PDF | 복사한 표가 제대로 붙여넣어지는지 먼저 확인 | OCR 없이도 옮길 수 있는지 |
| 여러 페이지에 걸친 표 | 각 페이지를 따로 인식한 뒤 엑셀에서 정리 | 반복된 제목·헤더와 이어지는 행 |
이미지 Excel 변환의 입력은 JPG, PNG, HEIC, AVIF, WebP, SVG입니다. PDF는 이 도구에 직접 넣지 않고 먼저 이미지로 변환합니다.
1단계: 스캔 PDF를 페이지별 PNG로 내보내기
이미 이미지 파일을 가지고 있다면 이 단계는 건너뛰세요.
- PDF를 이미지로를 열고 파일 추가로 PDF를 가져옵니다.
- 내보내기 방식은 PDF별 폴더를 선택합니다. 표 인식에는 여러 페이지를 긴 이미지 한 장으로 합치는 것보다 페이지별로 나누는 편이 검토하기 쉽습니다.
- 이미지 형식은 PNG, 해상도는 우선 300 DPI로 설정합니다. 작은 글자가 있는 표의 출발 설정으로 사용하되, 처리량이 부담되면 150 DPI로 시험해 보세요. 제공되는 선택지는 72·150·300 DPI입니다.
- 전체 문서가 필요하지 않다면 페이지 범위에 표가 있는 페이지만 지정합니다.
- 시작 · ZIP 출력을 누르고 완료된 ZIP을 다운로드합니다. 압축을 풀어 페이지 이미지를 준비합니다.
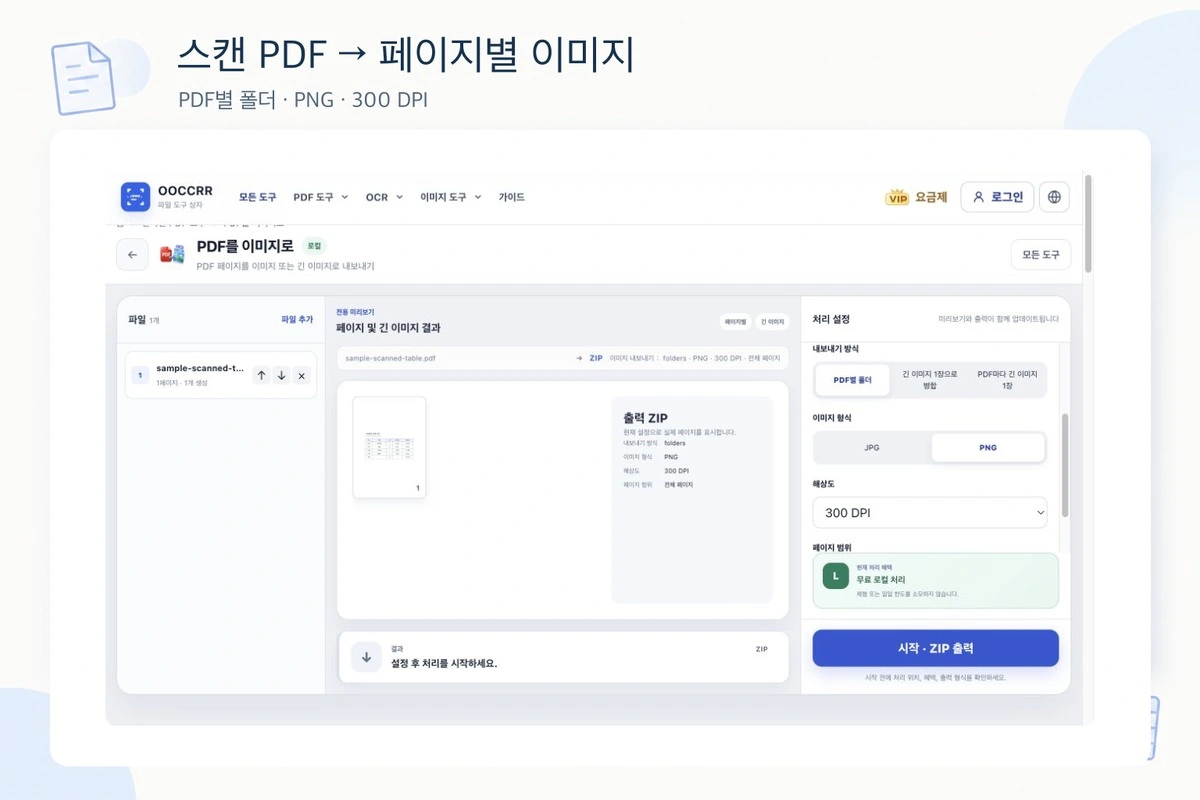
예시 PDF로 실행한 실제 화면을 AI로 보기 쉽게 정리했습니다. 버튼과 선택한 설정은 실제 도구와 같습니다.
PNG나 높은 DPI를 선택해도 이미 흐릿한 원본의 글자가 복구되지는 않습니다. 확대했을 때 숫자가 서로 붙어 보이거나 획이 사라진다면, 가능하면 더 선명한 스캔이나 원본 파일을 확보하세요.
2단계: 표 이미지를 가져오고 한국어를 선택하기
- 이미지 Excel 변환을 열고 이미지 추가를 누릅니다.
- 스크린샷이나 앞 단계에서 만든 페이지 이미지를 가져옵니다. 여러 이미지를 넣을 수 있으며, 도구의 입력 상한은 200개입니다. 처음에는 한두 장으로 결과를 확인한 뒤 나머지를 처리하세요.
- 처리 설정의 인식 언어를 한국어 / 영어로 바꿉니다. 좁은 화면에서는 설정 및 시작을 눌러 설정을 엽니다.
- 시작 · XLSX 출력을 누르고 처리가 끝날 때까지 페이지를 열어 둡니다.
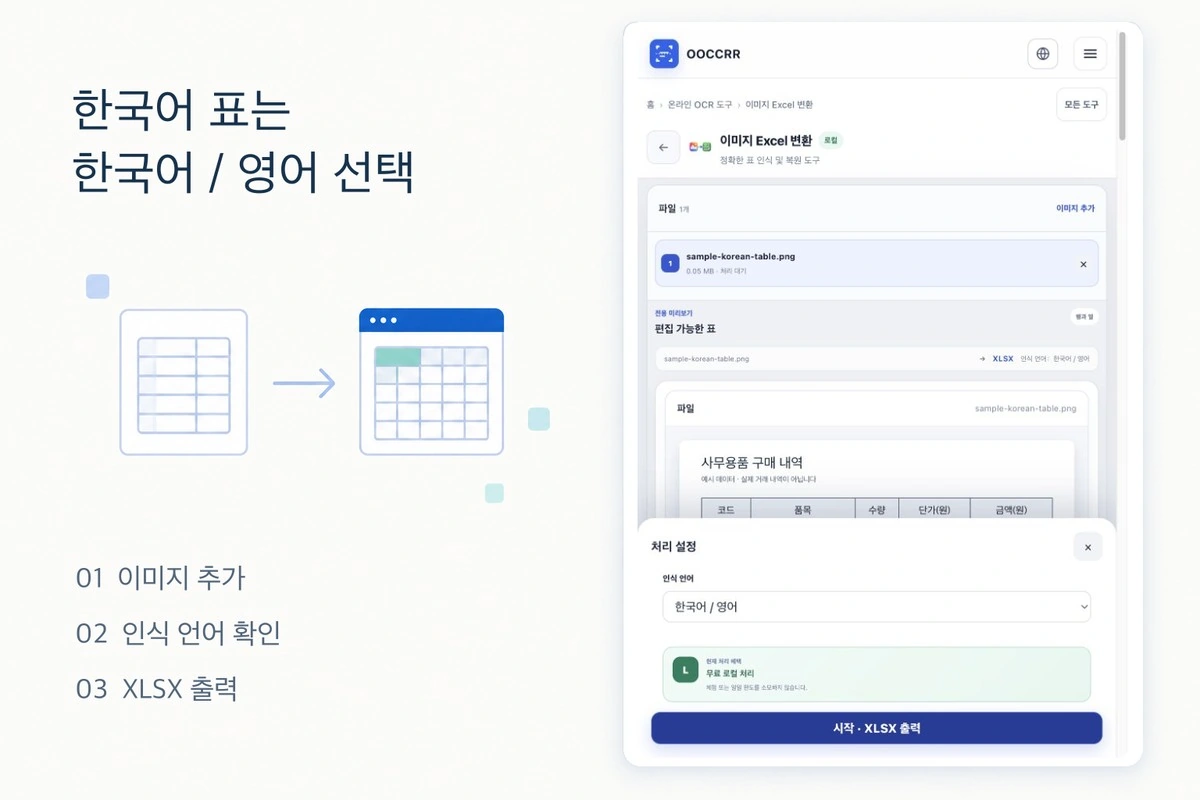
자체 제작한 구매 내역 표를 사용했습니다. 화면의 인식 언어와 버튼은 실제 UI이며, 주변 배경과 안내 문구는 읽기 쉽게 정리한 것입니다.
한국어 페이지를 열었다고 인식 언어가 자동으로 한국어가 되는 것은 아닙니다. 실제 설정값을 확인하세요. 영어가 섞인 한국어 표에도 한국어 / 영어를 선택할 수 있습니다.
3단계: 숫자와 행·열을 검토한 뒤 XLSX 다운로드하기
완료 화면에는 원본 이미지와 편집 가능한 인식 결과가 표시됩니다. 잘못 읽힌 셀은 화면에서 수정할 수 있습니다. 수정 후에는 결과 영역의 다운로드로 XLSX를 저장하고 엑셀에서 다시 확인하세요.
이 글의 예시에서는 사무용품 구매 내역이라는 제목이 표의 첫 행에 함께 들어갔고, 일부 숫자에는 원본에 없던 작은따옴표가 붙었습니다. 한글 품목명이 읽혔더라도 숫자와 표 구조까지 올바르다는 뜻은 아닙니다.
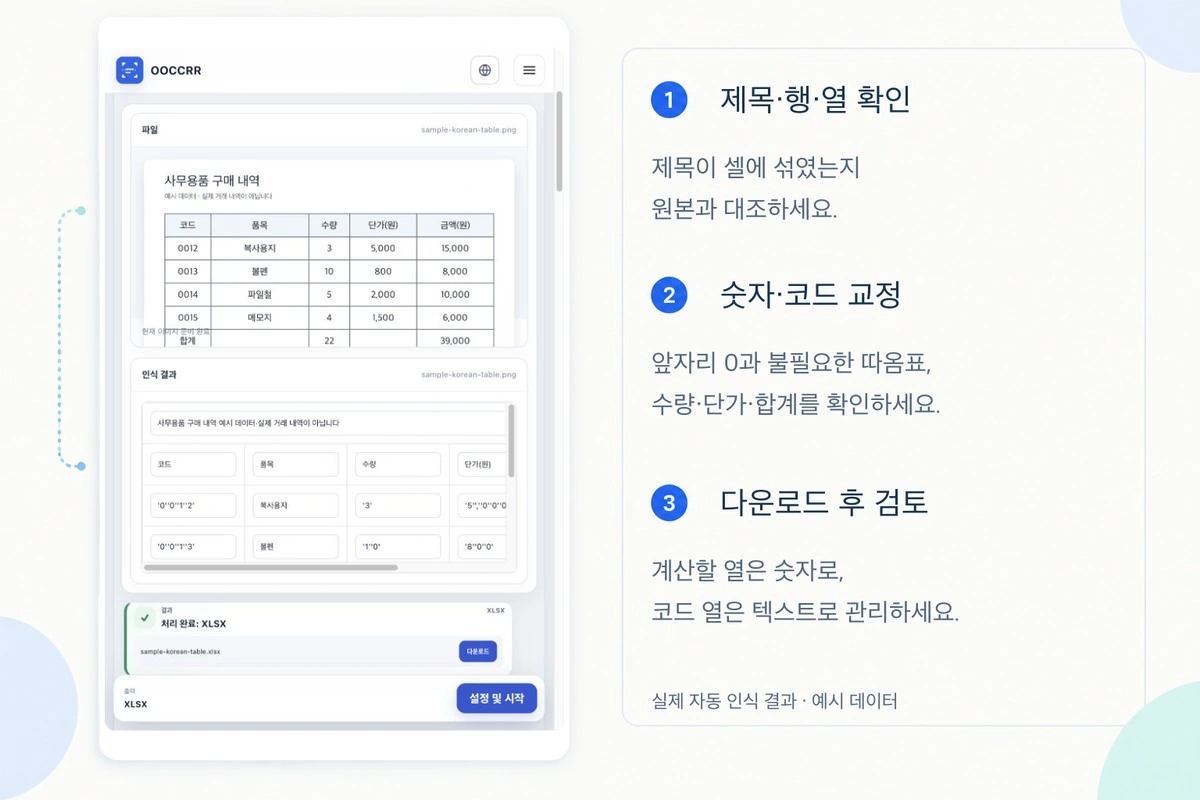
자동 인식 직후의 실제 결과를 보존한 이미지입니다. OCR 오류를 숨기거나 완벽한 표로 바꾸지 않았습니다. 예시 데이터는 실제 거래 내역이 아닙니다.
| 확인할 항목 | 예시 | 검토 방법 |
|---|---|---|
| 앞자리 0 | 품목 코드 0012 |
코드가 12로 바뀌지 않았는지 확인하고 엑셀에서 텍스트로 관리 |
| 수량·금액 | 수량 3, 단가 5,000, 금액 15,000 |
원본과 대조하고 불필요한 따옴표·공백 정리 |
| 합계 | 예시의 총액 39,000 |
각 행의 금액을 다시 합산해 원본 합계와 비교 |
| 제목·빈 행 | 표 위의 구매 내역 제목 | 데이터 행에 섞이지 않았는지 확인하고 엑셀에서 정리 |
| 행·열 대응 | 품목·수량·단가·금액 | 값이 옆 열로 밀리거나 두 행이 합쳐지지 않았는지 확인 |
엑셀에서 계산할 열은 숫자로 인식되는지도 확인하세요. 코드처럼 앞자리 0이 중요한 값과 금액처럼 계산할 값은 다르게 다뤄야 합니다. 금액 셀을 모두 선택한 뒤 합계가 예상대로 계산되는지 확인하면 문자열로 들어간 값도 찾기 쉽습니다.
여러 페이지를 처리했다면 파일별 결과를 검토한 뒤 필요한 행을 한 시트로 모으세요. 페이지마다 반복되는 열 제목을 중복 데이터로 넣지 않도록 주의합니다. 이 과정이 하나의 연속된 표를 자동으로 이어 붙여 주는 것은 아닙니다.
결과가 어긋날 때 확인할 내용
| 증상 | 먼저 시도할 방법 |
|---|---|
| 한글이 다른 글자로 읽힘 | 인식 언어가 한국어 / 영어인지 확인하고 원본 선명도 점검 |
| 제목이나 주변 문장이 셀로 들어감 | 표 영역만 포함한 이미지를 준비하거나 다운로드 후 불필요한 행 정리 |
| 작은 숫자를 읽기 어려움 | 원본을 확대해 확인하고 PDF 이미지 출력 해상도를 높여 재시도 |
| 열이 밀리거나 병합 셀이 어긋남 | 단순한 표 영역으로 나눠 시험하고 엑셀에서 구조를 직접 교정 |
| 많은 파일에서 처리 지연·실패 | 파일 수와 필요한 페이지를 줄여 나눠 처리하고 페이지를 열어 두기 |
회전된 사진, 그림자, 손글씨, 복잡한 다단 표는 별도의 검토가 필요합니다. 원본 엑셀의 수식이나 서식 정보는 사진에 남아 있지 않으므로, OCR로 원래 수식까지 복원할 수 있다고 기대하지 마세요.
자주 묻는 질문
Q: 스캔 PDF를 바로 엑셀로 변환할 수 있나요?
이 글의 OOCCRR 절차는 PDF를 페이지별 이미지로 내보낸 뒤 표 OCR로 인식하는 방식입니다. PDF를 이미지 Excel 변환에 직접 넣는 방식은 아닙니다. 이미 PNG나 JPG를 가지고 있다면 PDF 변환 단계를 건너뛸 수 있습니다.
Q: 한국어가 있는 표는 어떤 인식 언어를 선택하나요?
인식 언어에서 한국어 / 영어를 선택하세요. 사이트의 표시 언어와 OCR 설정은 별개이므로, 한국어 페이지에서도 설정값을 직접 확인해야 합니다. 한글과 영문이 섞인 표도 같은 설정으로 먼저 시험해 보세요.
Q: 문서를 서버에 업로드하나요?
본문에서 사용하는 PDF를 이미지로와 이미지 Excel 변환은 브라우저 로컬 처리 도구이며, 입력 문서를 서버에 업로드하지 않습니다. 사이트와 OCR 모델을 불러오는 데는 네트워크가 사용될 수 있으므로 완전한 오프라인 동작을 보장하는 뜻은 아닙니다. 다른 도구를 사용할 때는 해당 페이지의 처리 위치를 확인하세요.
Q: 무료인가요? 회원 가입이 필요한가요?
이 글의 두 도구는 무료 로컬 처리로 표시되며, 예시를 실행할 때 로그인이나 결제 없이 처리했습니다. 다른 클라우드 변환 도구의 이용 조건과는 다를 수 있습니다.
Q: 병합 셀과 엑셀 수식도 그대로 복원되나요?
표 구조를 추정해 셀을 만들지만 복잡한 병합 셀, 서식, 행·열 구성이 원본과 같다는 보장은 없습니다. 이미지에 보이는 값은 읽을 수 있어도 원본 파일의 수식은 복원할 수 없습니다. 구조와 숫자를 검토하고 필요한 수식은 엑셀에서 다시 작성하세요.
Q: 엑셀의 ‘그림에서 데이터’ 기능을 사용해도 되나요?
환경과 지원 언어가 맞는다면 선택지가 될 수 있습니다. 다만 확인일 기준 Microsoft의 그림에서 데이터 삽입 안내에 나열된 지원 언어에는 한국어가 포함되어 있지 않습니다. 한국어 표를 처리할 때는 지원 언어를 먼저 확인하세요. Microsoft도 인식 결과를 검토하고 필요한 내용을 수정하는 절차를 안내합니다.
한 장을 먼저 변환해 보세요
스크린샷이라면 이미지 Excel 변환에서 한국어 / 영어를 선택해 시작하세요. 스캔 PDF라면 PDF를 이미지로에서 필요한 페이지를 PNG로 내보낸 뒤 이어서 인식하면 됩니다. 첫 결과의 숫자와 행·열을 확인한 후 나머지 파일을 처리하면 됩니다.
제품 동작과 외부 도움말 확인일: 2026년 10월 8일. 예시 한 장의 결과는 일반적인 인식 정확도를 나타내는 측정값이 아닙니다.